Résumez cet article avec une IA :
Il y a quelques mois, un directeur des systèmes d'information m'a posé une question directe : "On a déployé Copilot pour tout le monde. Pourtant, la moitié de mes équipes continuent d'utiliser ChatGPT en dehors du périmètre. Qu'est-ce qu'on a raté ?"
Pas grand-chose sur le plan technique. Tout sur le plan de l'adoption.
C'est cette tension que je veux explorer ici : comment structurer un usage IA maîtrisé en entreprise sans créer les conditions du contournement que l'on cherche précisément à éviter.
Le Shadow AI n'est pas un problème de discipline
Quand un salarié utilise Claude ou Perplexity en dehors du cadre approuvé par son organisation, ce n'est généralement pas par mauvaise volonté. C'est parce que l'outil qu'on lui a imposé ne répond pas à ce qu'il fait concrètement dans sa journée.
Le Shadow AI est un signal, pas une faute.
Il dit que l'écart entre la solution déployée et les besoins réels est suffisamment grand pour que les utilisateurs acceptent le risque de sortir du cadre. Et cet écart, dans la plupart des organisations que j'observe, vient d'une décision prise trop tôt dans le mauvais sens : choisir un seul modèle, pour tout le monde, pour tous les usages.
Un modèle de langage n'est pas un outil universel. GPT-4o excelle sur certaines tâches de synthèse et de génération longue. Claude 3.5 Sonnet est souvent préféré pour les tâches d'analyse fine et les instructions complexes. Mistral ou Llama 3 présentent un intérêt différent dès lors que la souveraineté des données entre en jeu. Forcer une organisation entière dans un seul modèle, c'est demander à chaque métier de travailler avec l'outil qui n'est pas le sien.
Ce que "multi-LLM" signifie vraiment en pratique
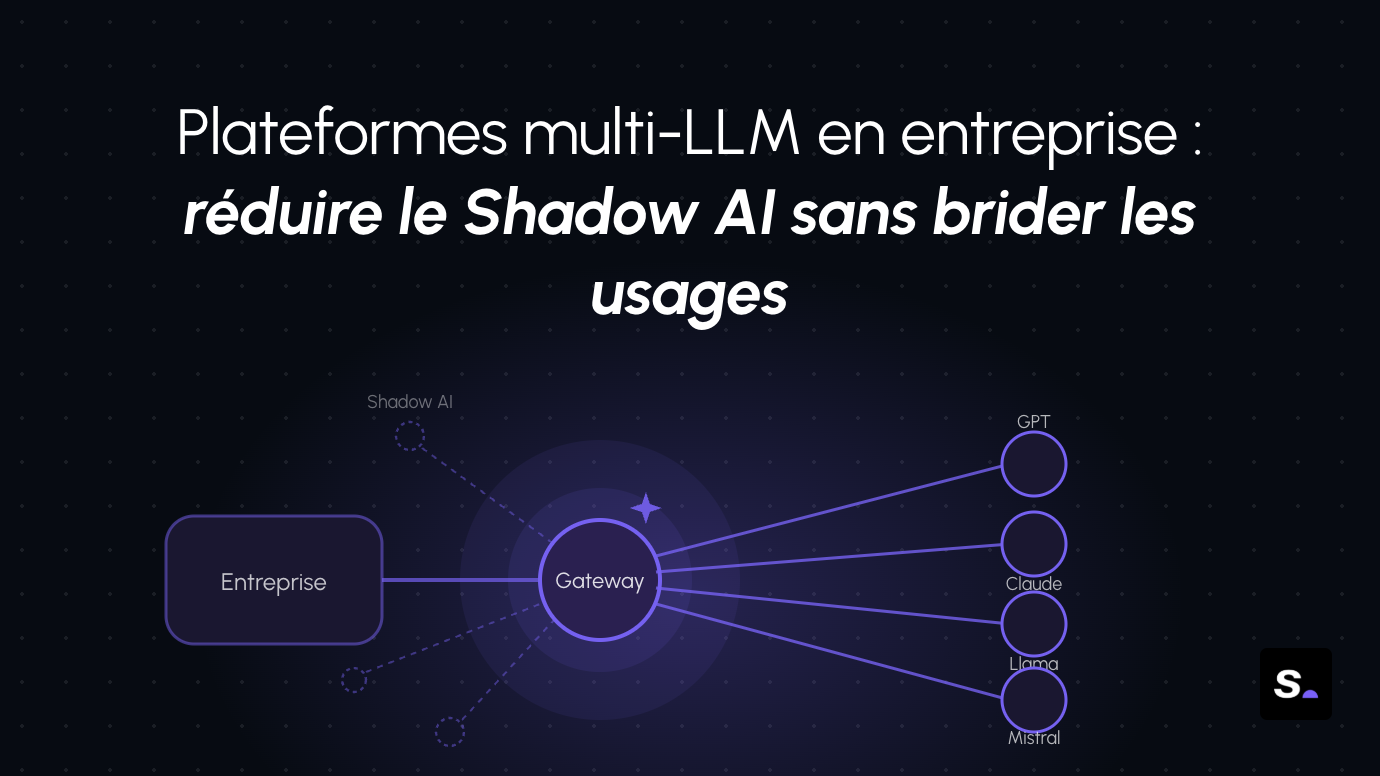
Une plateforme multi-LLM n'est pas une couche d'abstraction supplémentaire ajoutée pour le plaisir de la complexité. C'est une interface de gouvernance qui permet à l'organisation de décider, de manière centralisée et contrôlée, quels modèles sont accessibles, à qui, pour quoi, et dans quelles conditions.
Des solutions comme Langdock ou Dust opèrent sur ce principe. Elles ne remplacent pas les modèles sous-jacents : elles les agrègent, les encadrent et les rendent accessibles selon des règles définies par l'organisation, pas par l'éditeur du modèle.
Ce que cela change concrètement :
Un juriste peut accéder à Claude pour une tâche d'analyse contractuelle pendant qu'un développeur utilise GPT-4o pour générer de la documentation technique, le tout depuis la même interface, avec les mêmes politiques de sécurité, le même contrôle des données.
L'utilisateur retrouve le modèle avec lequel il est à l'aise. L'organisation garde la main sur ce qui sort, ce qui entre, et ce qui est consommé.
La gouvernance avant l'architecture
Le choix d'une plateforme multi-LLM est souvent présenté comme une décision technique. Je pense que c'est une erreur de cadrage.
C'est d'abord une décision de gouvernance.
Elle engage des questions qui dépassent largement le périmètre de la DSI : quels usages sont autorisés ? Qui valide les templates agentiques mis à disposition des équipes ? Comment l'organisation assume-t-elle sa responsabilité sur ce que ses collaborateurs produisent avec l'IA ?
Ces questions ne sont pas nouvelles. Elles existaient déjà avec les outils SaaS, avec les bases de données partagées, avec les politiques d'accès aux données clients. Ce qui est nouveau, c'est la vitesse à laquelle les usages IA se déploient et la difficulté à les rattraper une fois qu'ils sont installés.
Les plateformes multi-LLM offrent un cadre pour répondre à ces questions avant qu'elles ne deviennent des incidents. Mais encore faut-il les poser dans le bon ordre : gouvernance d'abord, architecture ensuite.
Le contrôle des tokens n'est pas un détail comptable
Un point souvent sous-estimé dans les déploiements IA en entreprise : la consommation de tokens est un indicateur de gouvernance, pas seulement un poste de coût.
Quand on ne contrôle pas la consommation, on ne sait pas ce que les équipes font réellement avec l'IA. On ne sait pas quels usages sont intensifs, quels workflows ont été construits en dehors des processus officiels, quelles données transitent dans les prompts.
Les plateformes multi-LLM permettent de suivre cette consommation par utilisateur, par équipe, par cas d'usage. Ce n'est pas de la surveillance : c'est de la visibilité. Et sans visibilité, il n'y a pas de pilotage possible.
C'est aussi ce qui permet d'optimiser. Certains usages ne nécessitent pas un modèle de grande taille. Une tâche de classification simple peut être traitée par un modèle moins coûteux, plus rapide, avec un impact carbone moindre. Cette granularité n'existe pas quand on déploie un seul modèle pour tout.
Le risque géopolitique que personne ne planifie
Il y a un angle que les organisations françaises et européennes intègrent encore trop peu dans leurs décisions d'architecture IA : la dépendance géopolitique aux modèles.
En 2024, plusieurs organisations ont découvert que l'accès à certains modèles non-américains pouvait être restreint ou interrompu selon les évolutions réglementaires et les tensions entre États. Ce n'est pas un scénario hypothétique : c'est une réalité documentée dans d'autres secteurs technologiques, et l'IA n'y échappe pas.
Miser sur un fournisseur unique de modèle, c'est accepter une dépendance qui peut devenir une vulnérabilité. Une architecture multi-LLM permet de diversifier cette dépendance : si un modèle devient inaccessible ou si ses conditions d'utilisation changent, l'organisation peut basculer sur un autre sans interrompre ses opérations.
C'est de la résilience opérationnelle, pas de la paranoïa.
Les templates agentiques : ce que personne ne dit assez
L'un des bénéfices les moins discutés des plateformes multi-LLM est l'accès à des bibliothèques de templates agentiques.
Un agent IA n'est pas un simple chatbot. C'est un workflow automatisé qui peut enchaîner des actions : chercher une information, la synthétiser, la formater, la transmettre à un autre système. Construire ces agents from scratch demande des compétences que la plupart des équipes métier n'ont pas.
Les plateformes multi-LLM sérieuses proposent des templates préconstruits pour des cas d'usage récurrents : analyse de documents, génération de rapports, qualification de données, assistance à la rédaction. Ces templates sont déjà calibrés pour fonctionner avec plusieurs modèles sous-jacents et peuvent être adaptés sans réécriture complète.
Ce que cela change pour les équipes métier : elles peuvent déployer des workflows IA sans dépendre d'un développeur pour chaque nouveau besoin. Ce que cela change pour la DSI : elle garde le contrôle sur ce qui est déployé, parce que tout passe par la plateforme centrale.
C'est ce que j'appelle une architecture qui réconcilie autonomie et contrôle. Les deux ne sont pas incompatibles si on les pense ensemble dès le départ.
La responsabilité éthique ne se délègue pas au modèle
Un point sur lequel je veux être explicite, parce qu'il est souvent esquivé dans les discussions techniques.
Quand une organisation déploie un outil IA à ses collaborateurs, elle assume une responsabilité sur ce que cet outil produit et sur la manière dont il est utilisé. Cette responsabilité ne se transfère pas à OpenAI, à Anthropic ou à Mistral AI.
Les plateformes multi-LLM permettent d'exercer cette responsabilité concrètement : en définissant des politiques d'usage, en filtrant certaines requêtes, en traçant les interactions, en limitant l'accès à certains modèles selon les profils d'utilisateurs.
Ce n'est pas de la censure. C'est de la gouvernance responsable.
Comme le note Kate Crawford dans Atlas of AI, les systèmes d'intelligence artificielle ne sont jamais neutres : ils reflètent des choix, des valeurs, des arbitrages. L'organisation qui déploie l'IA doit être capable de nommer ces choix et d'en répondre. Une plateforme de gouvernance multi-LLM est l'un des instruments qui rend cela possible.
Ce que cela implique pour les décideurs
Si vous êtes DSI, DRH, ou membre d'un comité de direction qui arbitre un déploiement IA, voici les questions que je vous invite à poser avant de valider une architecture :
Est-ce que notre solution permet à chaque métier d'accéder au modèle le plus adapté à ses besoins, ou est-ce qu'on impose un modèle unique pour simplifier la gestion ?
Est-ce qu'on a une visibilité sur ce qui est consommé, par qui, pour quoi ? Pas pour surveiller, mais pour piloter.
Est-ce qu'on a documenté notre politique d'usage de l'IA, et est-ce qu'elle est accessible aux utilisateurs finaux dans un format compréhensible ?
Est-ce qu'on a anticipé le scénario où l'accès à notre modèle principal est interrompu ou restreint ? Quelle est notre alternative ?
Est-ce qu'on a impliqué les équipes métier dans le choix de la solution, ou est-ce qu'on leur a présenté une décision déjà prise ?
Cette dernière question est souvent celle qui détermine si le déploiement sera adopté ou contourné.
Structurer sans brider : un équilibre qui se construit
Je ne crois pas qu'il existe une architecture parfaite. Je crois qu'il existe des architectures qui évoluent avec les usages et celles qui les figent.
Une plateforme multi-LLM bien déployée n'est pas une solution définitive. C'est un cadre qui permet à l'organisation d'apprendre : quels modèles fonctionnent pour quels usages, quelles équipes ont besoin d'accompagnement, quels workflows méritent d'être industrialisés.
Ce cadre n'a de valeur que si les utilisateurs s'y retrouvent. Et ils s'y retrouvent si on les a associés à sa construction, si on leur a expliqué les raisons des choix, si on leur a laissé la possibilité d'exprimer ce qui ne fonctionne pas.
L'IA n'adopte pas les organisations. Ce sont les organisations qui adoptent l'IA, et cette adoption est un processus humain avant d'être un déploiement technique.
Le Shadow AI disparaît quand les utilisateurs ont moins de raisons de contourner le cadre que de travailler dedans.
Alors la vraie question, celle que je pose à chaque organisation avec laquelle nous travaillons : est-ce que votre cadre IA actuel donne envie d'y rester ?
Envie d'aller plus loin avec l'IA et l'automatisation ?
symbolist. accompagne les entreprises de la stratégie à l'exécution, pour que la transformation IA soit réelle, adoptée et mesurable.
En discuter avec nous